L’essentiel
Un intervalle de confiance à 95 % est construit par une procédure qui, sous ses hypothèses, couvre le paramètre fixe dans 95 % des répétitions. Il ne signifie pas que ce paramètre possède 95 % de probabilité de se trouver dans cet intervalle particulier. Lisez l’estimation, ses deux bornes, l’unité et la méthode. Une différence se compare à zéro ; un rapport positif se compare à un. La fourchette ne corrige pas les biais et ne décide pas de l’importance pratique.
Que signifie vraiment un intervalle de confiance à 95 % ?
Un intervalle de confiance accompagne une estimation, par exemple une moyenne ou une différence entre deux groupes. Il comporte deux bornes calculées avec une méthode donnée. Pour une méthode qui atteint sa couverture annoncée, des échantillonnages répétés produiraient des intervalles contenant la valeur recherchée environ 95 % du temps. Le pourcentage décrit cette procédure, sous ses hypothèses[1].
Après le calcul d’un intervalle particulier, on ne transforme pas cette propriété en « 95 % de probabilité que la valeur vraie soit ici ». Dans le cadre fréquentiste habituel, le paramètre est fixé ; les échantillons et les intervalles varient. Le NIST insiste sur cette distinction dans sa présentation des limites de confiance d’une moyenne[2]. Elle évite de prêter au résultat une signification qu’il n’a pas.
Cela ne rend pas la fourchette inutile. Elle oblige à regarder autre chose que le chiffre central. Une différence estimée à quatre secondes ne raconte pas la même histoire avec des bornes de trois à cinq secondes qu’avec des bornes de moins une à neuf secondes. Ces nombres sont inventés. Avant de les commenter, il faut encore savoir quelle tâche est chronométrée, chez qui et dans quelles conditions.
Quelles informations faut-il lire avec les deux bornes ?
Commencez par nommer le paramètre : moyenne, proportion, différence, rapport ou autre quantité. Ajoutez son unité. Un intervalle entre deux et six peut désigner des secondes, des points sur une échelle ou un rapport sans unité. La taille visuelle du segment ne permet pas de deviner cette information. Deux résultats utilisant des échelles différentes ne se comparent pas en regardant seulement leurs décimales.
Retrouvez ensuite la population, le moment de la mesure et la comparaison. Dans un exercice fictif, une durée moyenne observée pendant une tâche courte ne décrit pas toutes les activités de la journée. De même, le résultat d’un groupe ne donne pas la durée qu’obtiendra chaque personne. Notre dossier sur le risque absolu et le risque relatif montre pourquoi les dénominateurs et la période restent attachés aux nombres.
L’Université de Lorraine replace l’estimation par intervalle dans les fluctuations d’échantillonnage[3]. Cette origine ne dispense pas de lire la méthode de sélection des participants. Notez « information absente » si le résumé ne précise pas le recrutement ou la mesure. Une fiche incomplète mais fidèle aide davantage qu’une explication complète construite avec des suppositions.
Un intervalle étroit rend-il une étude plus fiable ?
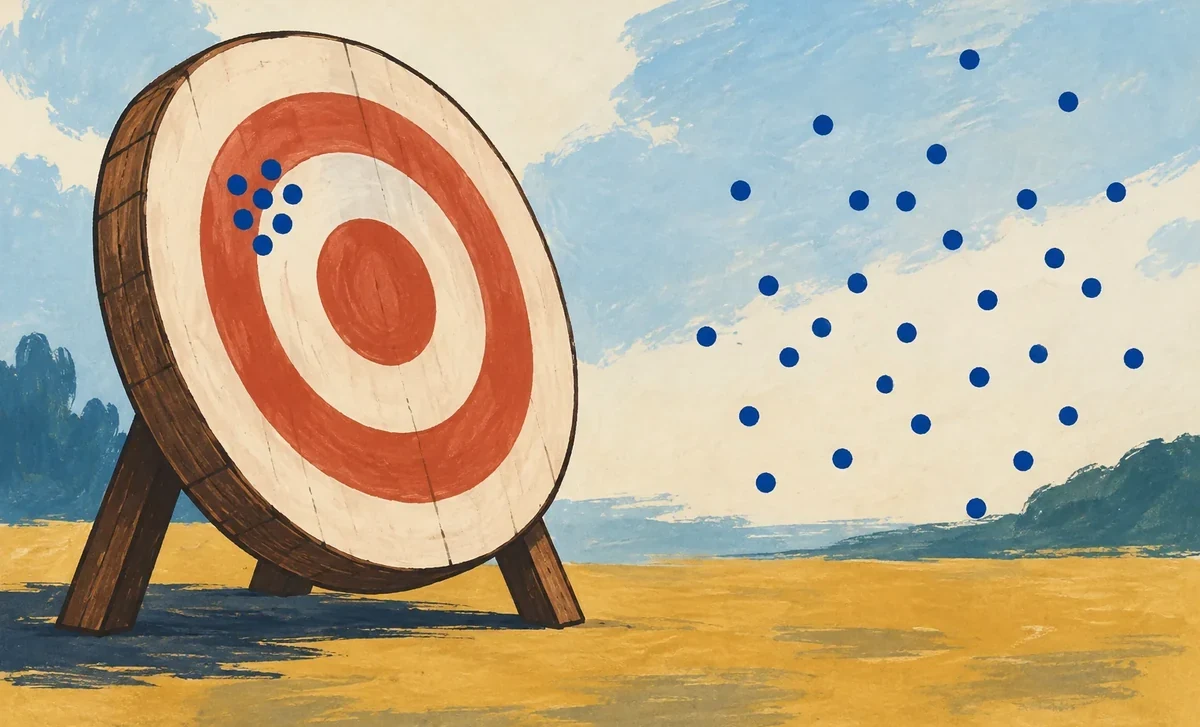
Dans un cadre de calcul comparable, un intervalle étroit traduit une estimation plus précise. Il ne certifie pas à lui seul que la mesure est pertinente ou que l’étude est bien conduite. Une balance mal réglée peut produire des valeurs très proches les unes des autres. L’image aide à distinguer dispersion et décalage ; elle ne constitue pas un modèle complet de tous les biais d’une enquête.
La largeur dépend notamment de la variabilité des données, de l’effectif et du niveau de confiance retenu. Pour la moyenne d’une population normale avec un écart-type connu, la demi-largeur vaut le coefficient choisi multiplié par cet écart-type, puis divisé par la racine carrée de l’effectif. Les hypothèses sont une partie de la formule, pas une note que l’on peut retirer.
Dans ce modèle simplifié, multiplier l’effectif par quatre divise la demi-largeur par deux si les autres éléments restent identiques. Passer de 25 à 100 observations illustre cette relation. Notre atelier n’est pas un calculateur universel : il maintient les conditions visibles et ne remplace pas une analyse lorsque les observations sont dépendantes, sélectionnées ou fortement différentes du modèle utilisé.
Morey et ses collègues discutent plusieurs interprétations abusives des intervalles de confiance[4]. Leur analyse rappelle qu’une règle intuitive sur la largeur ne vaut pas indistinctement pour toutes les constructions possibles. Pour comparer deux publications, recherchez aussi la façon dont l’intervalle a été obtenu. Des segments dessinés avec le même style peuvent provenir de méthodes différentes.
Qu’est-ce qui change la largeur ?
Modifiez uniquement deux paramètres du même modèle simplifié. Ces nombres inventés ne choisissent pas une méthode pour une étude réelle.
Moyenne fictive fixée à 10 ; modèle normal à écart-type connu. Marge = 1,959964 × σ / √n.
Le récapitulatif
| n | Marge approximative | IC à 95 % fictif |
|---|---|---|
| 25 | 3,92 | 6,08 à 13,92 |
| 100 | 1,96 | 8,04 à 11,96 |
| 400 | 0,98 | 9,02 à 10,98 |
La marge est divisée par deux lorsque n est multiplié par quatre, si σ, le niveau et la méthode restent identiques. Cela ne mesure ni un biais ni la dispersion de chaque personne.
Pourquoi regarde-t-on zéro dans un cas et un dans l’autre ?
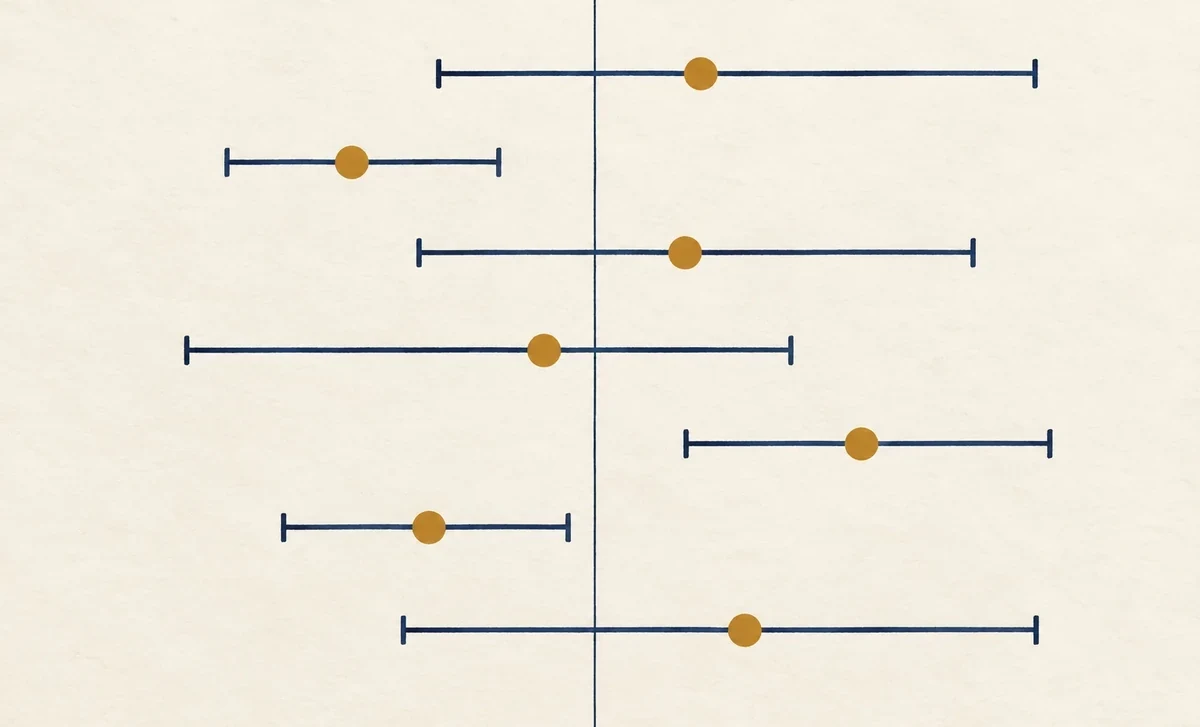
Pour une différence, zéro correspond à l’absence de différence sur l’échelle choisie. Dans notre exemple fictif de temps, un intervalle de moins une à neuf secondes contient zéro. Il laisse donc ouverte une absence de différence dans le cadre de l’analyse. Le fait que le chiffre central soit positif ne suffit pas à exclure cette possibilité.
Pour un rapport, la valeur de référence est généralement un : une quantité divisée par une quantité égale donne un. Un rapport accompagné d’un intervalle de 0,8 à 1,4 contient cette référence. Le même raisonnement appliqué à zéro serait une erreur de mesure. Il faut identifier le type de résultat avant de demander si l’intervalle franchit une ligne.
Le lien avec un test statistique dépend de tests et d’intervalles correspondants, avec les mêmes hypothèses et le même caractère unilatéral ou bilatéral. Le NIST présente cette correspondance dans le cas d’une moyenne[5]. On ne peut pas raccorder arbitrairement un test d’un côté à un intervalle construit autrement de l’autre.
L’atelier de lecture accepte un exemple de différence ou de rapport. Il indique si la référence se trouve entre les bornes et rappelle ce qu’il manque pour interpréter le résultat. Il ne déclare pas qu’une intervention « fonctionne ». La valeur pratique d’une différence, ses contraintes et les conséquences d’une décision demandent d’autres informations que sa position par rapport à une ligne.
Zéro ou un : quelle référence regarder ?
Entrez des valeurs inventées. L’estimation doit rester entre les bornes ; les rapports doivent être strictement positifs. Le résultat décrit seulement la fourchette.
Le récapitulatif
| Mesure fictive | Intervalle | Lecture |
|---|---|---|
| Différence, estimation 2 | −1 à 5 | Contient 0 ; plusieurs différences restent dans la fourchette. |
| Différence, estimation 2 | 1 à 3 | Exclut 0 ; cela ne prouve pas une importance pratique. |
| Rapport, estimation 1,1 | 0,8 à 1,4 | Contient 1 ; 1 est la valeur nulle d’un rapport. |
Conserver la population, l’unité, la durée, le niveau de confiance, la méthode et les limites. L’atelier ne valide pas un protocole et ne décide pas d’un traitement.
Que montrent des intervalles calculés sur plusieurs échantillons ?
La simulation représente une situation volontairement simple : des observations indépendantes provenant du même modèle normal, une moyenne réelle connue dans ce monde fictif et un écart-type connu. À chaque répétition, une nouvelle estimation produit un nouvel intervalle. Certaines fourchettes couvrent la moyenne fixée ; d’autres passent à côté. La moyenne du modèle ne se déplace pas pour suivre les traits.
Un lot de vingt répétitions n’a pas l’obligation d’en montrer exactement dix-neuf qui couvrent la valeur. Le niveau de 95 % décrit un comportement sur de nombreuses répétitions, pas un quota à respecter dans chaque petit lot. Forcer le dessin à afficher toujours le même nombre de réussites donnerait une intuition trompeuse. La simulation conserve donc les variations et sa graine pédagogique visible.
Ce modèle utilise la formule à écart-type connu décrite par le NIST[1]. Dans une étude réelle, cet écart-type est souvent estimé à partir des données, avec d’autres ajustements. Une observation isolée de notre simulation ne permet pas de choisir la meilleure méthode pour une enquête réelle. Elle sert à comprendre pourquoi une procédure peut avoir une couverture annoncée sans révéler si un intervalle particulier est le bon.
Sans JavaScript, le récapitulatif conserve les hypothèses et un exemple de lecture. Avec JavaScript, modifier la graine génère un autre lot fictif. Aucun résultat ne provient de patients, de clients ou d’une mesure du monde réel. Les champs n’envoient rien et ne demandent aucune information personnelle.
Pourquoi 95 % ne décrit pas un intervalle isolé
Le modèle tire directement vingt moyennes fictives selon leur distribution théorique normale, puis construit leurs intervalles. La graine permet de retrouver le même lot. Les mots « contient » et « ne contient pas » restent visibles sans dépendre des couleurs.
Le récapitulatif
| Paramètre | Valeur imposée |
|---|---|
| Moyenne de la population fictive μ | 10 |
| Écart-type connu σ | 10 |
| Effectif de chaque échantillon n | 100 |
| Moyenne simulée | Loi normale de moyenne 10 et d’écart-type 1 |
| Intervalle construit | Moyenne simulée ± 1,959964 |
Exemple de lecture : 8,04 à 11,96 contient μ = 10 ; 10,24 à 14,16 ne le contient pas. Les vingt répétitions ne doivent pas produire exactement dix-neuf couvertures. Aucun patient ni résultat réel n’est représenté.
Un intervalle qui contient zéro prouve-t-il l’absence d’effet ?
Non. Une fourchette peut être assez large pour contenir à la fois une absence de différence et des différences qui compteraient dans la pratique. La conclusion utile décrit cette incertitude. Dans un exemple inventé, des bornes de moins huit à douze secondes n’autorisent pas la même discussion que des bornes de moins une dixième à une dixième de seconde, même si les deux contiennent zéro.
Le chapitre d’interprétation du Cochrane Handbook conseille de ne pas réduire la conclusion à l’étiquette « significatif » ou « non significatif »[6]. Il faut regarder la taille de l’effet envisagé, les bornes, la certitude des preuves et la décision concernée. Aucune de ces dimensions ne se déduit entièrement d’un seuil.
L’erreur inverse existe aussi. Un intervalle qui exclut zéro peut entourer une différence trop petite pour répondre au besoin réel, ou provenir d’un protocole présentant des limites. Greenland et ses collègues examinent les raccourcis autour des tests, de la puissance et des intervalles[7]. Leur discussion encourage une lecture du plan d’analyse plutôt qu’une confiance automatique dans une formule courte.
Ne jugez pas non plus la différence entre deux groupes en regardant seulement si leurs deux intervalles individuels se chevauchent. La quantité à étudier est leur comparaison, avec son calcul propre. Si elle manque dans le document, notez cette absence au lieu d’inventer un test visuel à partir d’un graphique.
Quelles incertitudes restent en dehors de la fourchette ?
Un intervalle ne corrige pas automatiquement les erreurs de mesure, les données manquantes, une sélection particulière ou des choix d’analyse effectués après lecture des résultats. Son calcul répond à une question sous des hypothèses. Demandez lesquelles restent crédibles dans l’étude. Un très grand échantillon ne rend pas sans importance la manière dont il a été constitué.
En médecine d’urgence, les repères de la SFMU présentent l’intervalle comme un outil pour encadrer une estimation : il faut donc nommer le paramètre étudié avant de lire ses bornes[10].
Il faut aussi séparer estimation et causalité. Une association mesurée avec précision peut encore recevoir plusieurs explications. Le dossier sur la corrélation et la causalité développe les facteurs de confusion et le sens de la relation. Le guide sur l’effet placebo et nocebo précise le rôle des comparateurs. Ces questions complètent l’intervalle ; elles ne lui sont pas incorporées par magie.
Enfin, la présentation influence la compréhension. La revue de Zipkin et ses collègues porte sur plusieurs formats de communication des risques ; elle ne valide pas une forme unique pour toutes les situations[8]. Notre choix est donc de montrer ensemble l’estimation, les bornes et le contexte. Le graphique garde son échelle, et la prose conserve les limites qui ne tiennent pas dans une légende.
Quelle phrase garder pour expliquer un résultat sans le surinterpréter ?
Une formulation de travail peut commencer ainsi : « Dans cette population et pour cette mesure, l’estimation est de…, avec un intervalle de confiance à 95 % de… à…, calculé selon… ». Ajoutez ensuite ce que ces valeurs changeraient dans la pratique et ce que le protocole ne permet pas de trancher. Si une information est inconnue, laissez-la visible. Le glossaire scientifique donne des repères de vocabulaire ; les définitions de l’étude restent prioritaires.
Les recherches de Gigerenzer et ses collègues soulignent le rôle d’une présentation transparente des statistiques de santé[9]. Ici, cela consiste à garder le nom de la mesure près de ses nombres et à éviter de transformer une fourchette en résultat personnel. Le dossier sur les sénolytiques offre un autre contexte où distinguer mécanisme, observations et application. Les travaux sur le régime méditerranéen demandent eux aussi de retrouver les populations et les comparaisons.
La vidéo du Centre de collaboration nationale des méthodes et outils présente les intervalles de confiance à partir d’un scénario pédagogique. Elle complète les ateliers. Pour l’interprétation fréquentiste précise du niveau de 95 %, gardez la définition de procédure répétée donnée au début de ce dossier ; une expression orale abrégée ne doit pas remplacer ses hypothèses. La vidéo emploie aussi le mot « inefficace » pour un résultat dont l’intervalle traverse la valeur nulle : retenez notre distinction précédente, car ce franchissement ne prouve pas une absence d’effet.
Vrai ou faux : cinq idées reçues
Choisissez votre réponse, l’explication s’affiche aussitôt.
Un IC à 95 % contient 95 % des personnes observées.
Voir la réponse
Faux. Il encadre un paramètre selon une procédure ; ce n’est pas la dispersion des individus.
Un rapport positif se compare à un pour l’absence de différence.
Voir la réponse
Vrai. Deux quantités égales ont un rapport de un, si le rapport est défini.
Un intervalle qui contient zéro prouve une absence d’effet.
Voir la réponse
Faux. Les bornes peuvent aussi inclure des différences pertinentes.
Dans notre modèle inchangé, multiplier n par quatre divise la marge par deux.
Voir la réponse
Vrai. La marge dépend de 1 / racine carrée de n.
Une grande taille d’échantillon supprime automatiquement les biais.
Voir la réponse
Faux. La sélection, les mesures et le protocole restent à examiner.
Questions fréquentes
Un intervalle à 95 % signifie-t-il 95 % de probabilité pour mon résultat ?
Dans l’interprétation fréquentiste utilisée ici, le paramètre est fixe et les intervalles changent selon les échantillons. Le niveau de 95 % décrit la procédure sur des répétitions, sous ses hypothèses. Une fois calculé, un intervalle particulier couvre ou ne couvre pas ce paramètre. Un intervalle de crédibilité bayésien correspond à une autre construction, avec ses propres hypothèses.
Un intervalle plus étroit est-il toujours meilleur ?
À méthode, mesure, population et niveau comparables, il indique une moindre incertitude d’échantillonnage selon ce calcul. Il ne prouve pas que les observations soient représentatives ou exemptes d’erreurs. Une fourchette étroite autour d’une mesure biaisée peut donner une impression trompeuse. Ne comparez pas directement la largeur de deux mesures exprimées dans des unités différentes.
Pourquoi regarder zéro pour une différence et un pour un rapport ?
Une différence égale à zéro correspond à deux quantités égales. Leur rapport, lorsque le dénominateur est défini et positif, est alors égal à un. Le choix de référence dépend donc de la mesure. Notre atelier distingue ces deux cas et rejette les rapports non positifs ; il ne transforme pas une référence franchie en verdict sur une intervention.
Contenir zéro prouve-t-il que rien ne se passe ?
Non. L’intervalle peut aussi contenir des différences qui auraient une importance pratique. Décrivez les bornes et les limites de l’étude au lieu de conclure uniquement « aucun effet ». Inversement, exclure zéro n’établit ni une cause ni une importance clinique. Une analyse d’équivalence exige une question et des marges définies dans un cadre adapté.
La simulation doit-elle montrer dix-neuf intervalles corrects sur vingt ?
Non. Le nombre de couvertures varie d’un petit lot à l’autre. Le niveau théorique de 95 % concerne la procédure sur de nombreuses répétitions du modèle. Notre simulation génère directement des moyennes normales fictives, avec un écart-type connu et une graine affichée. Elle ne reproduit pas des patients et ne sert pas à prévoir un résultat individuel.
Sources & pour aller plus loin
Publications scientifiques et ressources institutionnelles. Les limites et l’interprétation sont discutées dans le texte.
- NIST — Définition et couverture d’un intervalle de confiance ↗
- NIST — Intervalle de confiance pour une moyenne ↗
- Université de Lorraine — Définition d’un intervalle de confiance ↗
- Morey et al., 2016 — The fallacy of placing confidence in confidence intervals ↗
- NIST — Test bilatéral et intervalle pour une moyenne ↗
- Cochrane Handbook — Chapitre 15, interpréter les résultats, mise à jour août 2023 ↗
- Greenland et al., 2016 — Tests, valeurs p et intervalles : erreurs d’interprétation ↗
- Zipkin et al., 2014 — Communication des risques : revue systématique ↗
- Gigerenzer et al., 2007 — Helping Doctors and Patients Make Sense of Health Statistics ↗
- SFMU — Intervalle de confiance : repères pour lire une estimation clinique ↗
Références examinées pour cette mise à jour : 15 octobre 2026.